https://tool.oschina.net/regex/ 在线正则匹配工具
使用自带的re库可实现正则
https://docs.python.org/zh-cn/3/library/re.html 库介绍
https://cloud.tencent.com/developer/article/1607481 简单用法
import re
match_pattern = re.compile(r'\'\s*type\s*\'\s*:\s*\'\s*phrase\s*\'')
string = "'type':'phrase'"
print(match_pattern.findall(string))
print(match_pattern.finditer(string))
print(match_pattern.search(string))
re.finditer(pattern, string, flags=0)
pattern 在 string 里所有的非重复匹配,返回为一个迭代器 iterator 保存了 匹配对象 。 string 从左到右扫描,匹配按顺序排列。空匹配也包含在结果里。
for idx,val in enumerate(re.finditer(string)):
    print(val)
finditer也是完全匹配整个正则表达式的
re.sub(pattern, repl, string, count=0, flags=0)
返回通过使用 repl 替换在 string 最左边非重叠出现的 pattern 而获得的字符串。 如果样式没有找到,则不加改变地返回 string。 repl 可以是字符串或函数;如为字符串,则其中任何反斜杠转义序列都会被处理。 也就是说,\n 会被转换为一个换行符,\r 会被转换为一个回车符,依此类推。 未知的 ASCII 字符转义序列保留在未来使用,会被当作错误来处理。 其他未知转义序列例如 & 会保持原样。
print(re.sub(match_pattern,'',string))
print(match_pattern.sub('',string))
# 'type':'phrase' ==> ''
要注意,python中的字符串是不可变对象,所以函数处理后是不会改变原对象的,需要赋值给某个变量才能拿到结果进一步处理
re.search(pattern, string, flags=0)
扫描整个 字符串 找到匹配样式的第一个位置,并返回一个相应的 匹配对象。如果没有匹配,就返回一个 None ; 注意这和找到一个零长度匹配是不同的。
search是整个正则表达式完整匹配,匹配到了就返回第一个找到的结果,匹配不到返回None
re.findall(pattern, string, flags=0)
Return all non-overlapping matches of pattern in string, as a list of strings or tuples. The string is scanned left-to-right, and matches are returned in the order found. Empty matches are included in the result.The result depends on the number of capturing groups in the pattern. If there are no groups, return a list of strings matching the whole pattern. If there is exactly one group, return a list of strings matching that group. If multiple groups are present, return a list of tuples of strings matching the groups. Non-capturing groups do not affect the form of the result.
re.findall(r'\bf[a-z]*', 'which foot or hand fell fastest')
['foot', 'fell', 'fastest']
re.findall(r'(\w+)=(\d+)', 'set width=20 and height=10')
[('width', '20'), ('height', '10')]
findall,如果正则表达式中有小括号括起来的对,只要有多少对小括号组合,就对应有多少个分组,会用这些分组去匹配搜索字符串,如果有多个分组,那么搜索结果是一个多元组的列表,如果只有一个分组,那么结果就是一个字符串列表;总之不是完整匹配正则表达式,用法比较灵活
https://zhuanlan.zhihu.com/p/37900841
正则匹配的一些规则
这里先收集一些常用的正则匹配符号,后续使用到继续补充
1、句号.
匹配除换行符以外的所有字符
2、\s \S
\s表示匹配空白符,包括制表符、换行符、空格
\S表示匹配除空白符以外的字符,与\s刚好相反
3、\d \w
\d 匹配数字
\w 匹配字母、数字、下划线、汉字
\W 匹配任意不是字母、数字、下划线、汉字的字符
\D 匹配任意不是数字的字符
4、重复匹配
- 表示匹配星号前的字符任意数量,0个或0个以上
- 表示匹配加号前的字符,1个或1个以上
? 表示匹配0次或1次
{n} 表示前面的字符重复n次
{n,} 表示前面的字符重复n次或n次以上
{n,m} 表示前面的字符重复n-m次
*和+都是贪婪匹配,使用这种模式,会尽可能多的匹配到所有的字符,可以搭配?来使用非贪婪匹配,只要即最短的满足匹配规则的内容:
match_pattern=r'<.*>'
match_pattern2=r'<.*?>'
string='<h1>helloworld<\h1>'
// match_pattern 匹配到整个字符串
// match_pattern2 匹配到<h1>
5、中括号
中括号[]里的字符表示匹配其中任意一个就行
例如[a-z0-9]匹配字母a到z,数字0到9的字符,如果待匹配字符串包含这些字符中的一个就会被匹配到
6、反选 ^
[^a] 表示匹配a以外的所有字符
[^aeiou] 表示匹配aeiou以外的所有字符
7、分组 ()
用小括号括起来的内容是整体匹配的,例如(abc)就要求字符串必须包含abc子串才会被匹配
也可以做选择,通过|符号表示:
(abc|def)表示整体既可以匹配abc也可以匹配def
多个中括号代表多个捕获分组,re.findall就是查询所有匹配到的分组,每一个分组查到的结果会放在一个元组中,一个数组有多个元组,元组个数对应捕获分组数量
但用圆括号会有一个副作用,只会使相关的匹配会被缓存,例如下面的例子中,第一个案例只有123和456两个匹配结果,没有runoob的内容。;此时可用 ?: 放在第一个选项前来消除这种副作用。
()表示捕获分组,()会把每个分组里的匹配的值保存起来,使用$n(n是一个数字,表示第n个捕获组的内容)
(?:)表示非捕获分组,和捕获分组唯一的区别在于,非捕获分组匹配的值不会保存起来
对比效果
string2='runoob123runoob456'
pattern=re.compile(r'runoob([0-9]+)')
res=pattern.findall(string2)
print(res)
// output
['123', '456']

string2='runoob123runoob456'
pattern=re.compile(r'runoob([?:0-9]+)')
res=pattern.findall(string2)
print(res)
// output
['runoob123', 'runoob456']
其中 ?: 是非捕获元之一,还有两个非捕获元是 ?= 和 ?!,这两个还有更多的含义,前者为正向预查,在任何开始匹配圆括号内的正则表达式模式的位置来匹配搜索字符串,后者为负向预查,在任何开始不匹配该正则表达式模式的位置来匹配搜索字符串
非捕获元:表示进行正则匹配的内容,但是返回结果的时候不会返回非捕获元匹配的内容
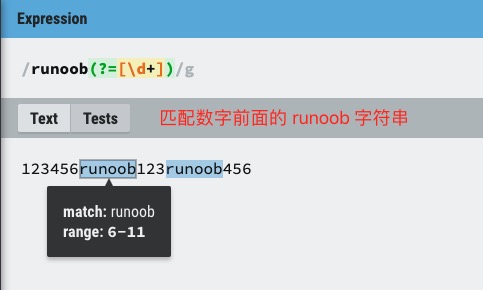
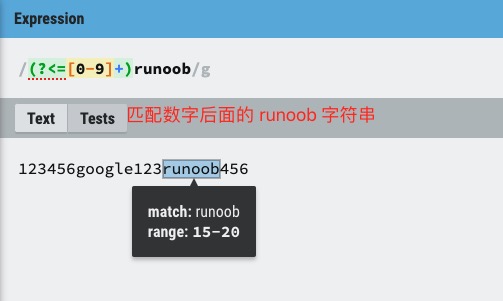
下面用了?=非捕获元,表示匹配数字的分组,但是不返回,所以匹配到的就是runoob

string='runoob123runoob456'
pattern1=r'runoob(?=[0-9]+)' // 匹配结果 runoob runoob
pattern2=r'(?<=[0-9]+)runoob' // 匹配结果 runoob 这是123runoob的runoob
string2='runoob123runoob-google'
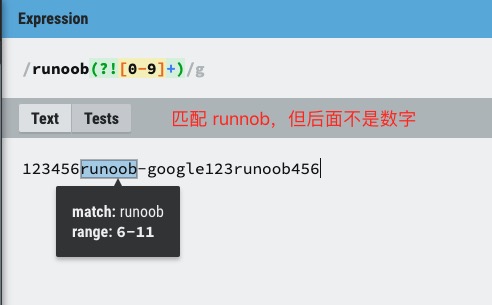
pattern3=r'runoob(?![0-9]+)' // 匹配结果 runoob  这是runoob-google的runoob
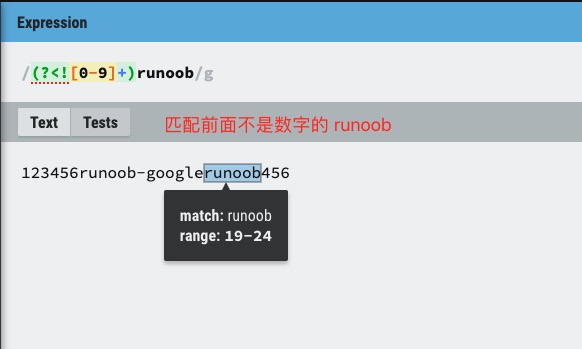
pattern4=r'(?<![0-9]+)runoob' //匹配结果 runoob 这是最前面的runoob
有小于号的写在前面,没有的写在后面
以下列出 ?=、?<=、?!、?<! 的使用区别(这几个都是不返回匹配的分组内容,只返回分组意外的匹配内容,而?:则是将分组和分组以外的匹配都返回)
exp1(?=exp2):查找 exp2 前面的 exp1。
(?<=exp2)exp1:查找 exp2 后面的 exp1。
exp1(?!exp2):查找后面不是 exp2 的 exp1。
(?<!exp2)exp1:查找前面不是 exp2 的 exp1。
8、非打印字符
| \cx | 匹配由x指明的控制字符。例如, \cM 匹配一个 Control-M 或回车符。x 的值必须为 A-Z 或 a-z 之一。否则,将 c 视为一个原义的 'c' 字符。 |
|---|---|
| \f | 匹配一个换页符。等价于 \x0c 和 \cL。 |
| \n | 匹配一个换行符。等价于 \x0a 和 \cJ。 |
| \r | 匹配一个回车符。等价于 \x0d 和 \cM。 |
| \s | 匹配任何空白字符,包括空格、制表符、换页符等等。等价于 [ \f\n\r\t\v]。注意 Unicode 正则表达式会匹配全角空格符。 |
| \S | 匹配任何非空白字符。等价于 [^ \f\n\r\t\v]。 |
| \t | 匹配一个制表符。等价于 \x09 和 \cI。 |
| \v | 匹配一个垂直制表符。等价于 \x0b 和 \cK。 |
9、定位符
定位符一般用于匹配以什么开头或者以什么结尾的内容
| ^ | 匹配输入字符串开始的位置。如果设置了 RegExp 对象的 Multiline 属性,^ 还会与 \n 或 \r 之后的位置匹配。 |
|---|---|
| $ | 匹配输入字符串结尾的位置。如果设置了 RegExp 对象的 Multiline 属性,$ 还会与 \n 或 \r 之前的位置匹配。 |
| \b | 匹配一个单词边界,即字与空格间的位置。 |
| \B | 非单词边界匹配。 |
string='hello world'
match_pattern=r'\bhel'
// 匹配结果 hel
match_pattern=r'llo\b'
// 匹配结果 llo
match_pattern=r'\Bell'
// 匹配结果 ell 如果string='ello' 则不会匹配
// \b可以理解成单词分界线 放前放后的意思就是在哪分界而已
// \B表示不在单词的分界线 所以ello不会被匹配到
